
Bác sĩ Linh, trưởng phòng công nghệ thông tin của một bệnh viện lớn tại Việt Nam, đang đối mặt với một vấn đề mà nhìn qua chẳng giống bài toán máy học chút nào. Bệnh viện của chị vừa triển khai hồ sơ bệnh án điện tử — hệ thống bệnh án giấy hóa không giấy mà Bạch Mai và Chợ Rẫy đi tiên phong và Bộ Y tế hiện đang đẩy mạnh trên hơn 1.200 bệnh viện. Hồ sơ chứa hai triệu lượt khám bệnh mỗi năm: X-quang ngực, kết quả xét nghiệm, tiêu bản giải phẫu bệnh, lịch sử tái nhập viện. Một mô hình sàng lọc được huấn luyện trên toàn bộ dữ liệu đó có thể phát hiện ung thư sớm hơn và dự đoán bệnh nhân nào cần chăm sóc đặc biệt. Dữ liệu đang ở ngay đó — và chính vì thế chị không thể dùng nó. Privacy machine learning y tế cho phép một bệnh viện huấn luyện AI trên hồ sơ bệnh nhân nhạy cảm trong khi hồ sơ không bao giờ rời khỏi tòa nhà, không bao giờ chạm đến nhà cung cấp đám mây, và không bao giờ phơi bày bất kỳ bệnh nhân đơn lẻ nào.
Nền tảng pháp lý không thể thương lượng. Nghị định 13/2023/NĐ-CP của Việt Nam xếp tình trạng sức khỏe ghi trong hồ sơ bệnh án là dữ liệu cá nhân nhạy cảm, và Luật Khám bệnh, chữa bệnh 2023 (Luật 15/2023/QH15) trao cho bệnh nhân quyền giữ bí mật hồ sơ của mình. Tải hàng loạt hồ sơ bệnh nhân lên một nhà cung cấp máy học trên đám mây là vi phạm luật như văn bản quy định. Vậy mà nhu cầu lâm sàng là có thật, và các bệnh viện dẫn đầu chuyển đổi số của Việt Nam đã huấn luyện AI trên dữ liệu hình ảnh của chính họ. Con đường giữa "dữ liệu không thể di chuyển" và "AI vẫn có thể học" chạy qua các kỹ thuật — học liên kết, tổng hợp an toàn, riêng tư vi phân và bằng chứng không tiết lộ — mà bài viết này lắp ráp thành một pipeline làm việc hoàn chỉnh.
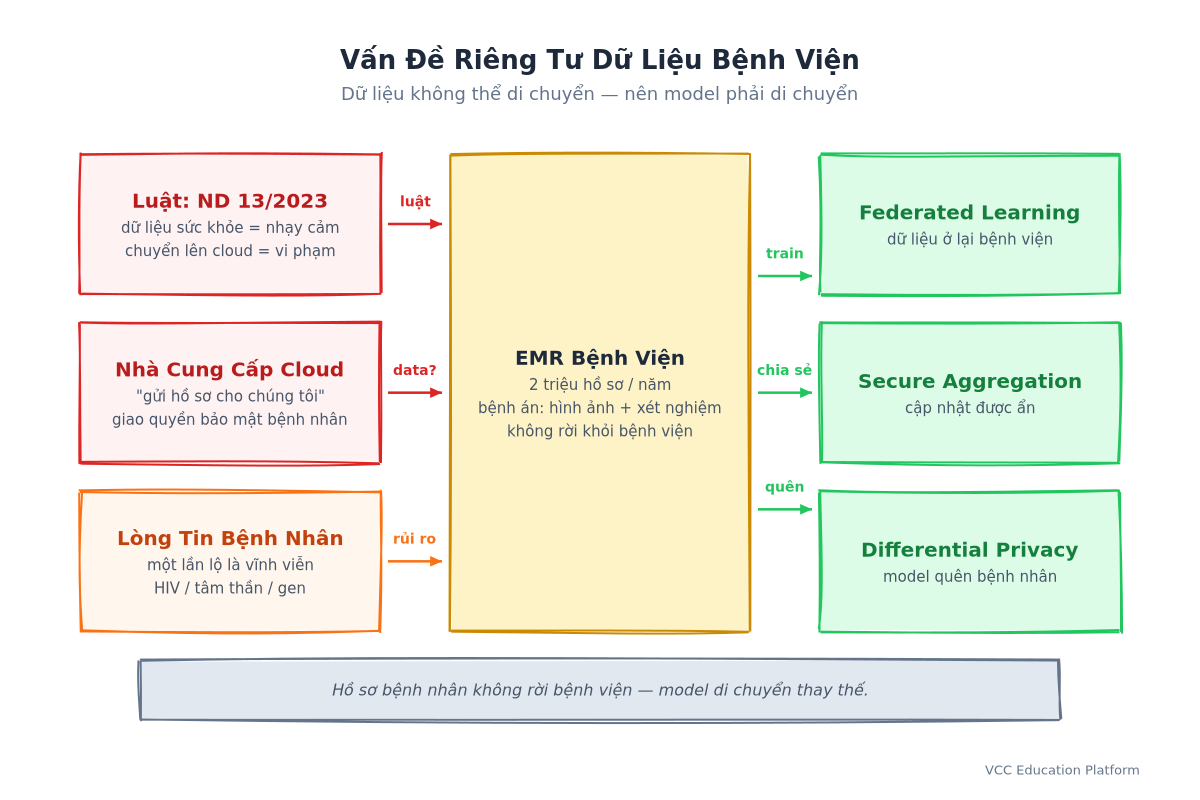
Vì sao "đưa dữ liệu lên đám mây" là ngõ cụt cho bệnh viện
Câu trả lời ngây thơ cho "chúng tôi muốn huấn luyện AI trên dữ liệu bệnh nhân" là gửi dữ liệu đến nơi có GPU. Với một bệnh viện Việt Nam, câu trả lời đó thất bại trên mọi khía cạnh. Về pháp lý, chuyển dữ liệu nhạy cảm đòi hỏi sự đồng ý và một khung xử lý được lập văn bản theo Nghị định 13/2023, còn các quy tắc bảo mật hồ sơ của Bộ Y tế gần như không để dư địa cho việc sử dụng nghiên cứu hàng loạt khi chưa có sự đồng ý rõ ràng của bệnh nhân. Về thực tiễn, dữ liệu bị khóa bên trong hệ thống thông tin bệnh viện (HIS) vốn chưa bao giờ được thiết kế để xuất các bộ dữ liệu chuẩn cho nghiên cứu — các bệnh viện dùng lược đồ, hệ mã hóa và cấu trúc hồ sơ khác nhau. Về đạo đức, thứ duy nhất một bệnh viện không bao giờ xây dựng lại được là lòng tin của bệnh nhân: một vụ lộ tình trạng nhiễm HIV, tiền sử tâm thần hay dữ liệu gen là tổn hại vĩnh viễn.
Tệ hơn, giải pháp chuẩn thời đám mây còn âm thầm làm cho bài toán riêng tư trở nên khó hơn. Huấn luyện tập trung nghĩa là trọng số của mô hình được huấn luyện trên mọi hồ sơ bệnh nhân trong bộ dữ liệu. Một mô hình là một bộ nhớ nén: các cuộc tấn công suy diễn thành viên (membership inference) thường có thể xác định liệu hồ sơ của một bệnh nhân cụ thể có nằm trong tập huấn luyện hay không, và các cuộc tấn công đảo ngược gradient trên ảnh y tế có thể tái tạo lại dữ liệu đầu vào có thể nhận diện được. Một bệnh viện giao hồ sơ cho nhà cung cấp không chỉ ủy thác quyền giữ dữ liệu — nó ủy thác luôn cả tính bảo mật cấp bệnh nhân mà pháp luật dành riêng cho chính bệnh viện.
Vậy ràng buộc là cố định: hồ sơ bệnh nhân thô không bao giờ rời khỏi hạ tầng của chính bệnh viện. Mọi thứ bên dưới đều được xây trên nền tảng đó.
Bộ công cụ huấn luyện ai riêng tư: ba lớp xếp chồng
Huấn luyện ai riêng tư — huấn luyện AI riêng tư — là một chồng gồm ba lớp, mỗi lớp giải quyết một kiểu thất bại khác nhau với một cái giá thật.Lớp 1: Học liên kết — hồ sơ ở nguyên vị trí, mô hình di chuyển
Học liên kết (federated learning) đảo ngược vòng huấn luyện. Thay vì gửi dữ liệu đến máy chủ trung tâm, một mô hình toàn cục được gửi đến từng bệnh viện tham gia. Mỗi bệnh viện huấn luyện mô hình cục bộ trên chính hồ sơ của mình — bên trong tường lửa của mình — rồi gửi về chỉ bản cập nhật mô hình (gradient hoặc trọng số), chứ không phải hồ sơ. Bộ điều phối lấy trung bình các bản cập nhật và gửi mô hình cải tiến trở lại cho vòng tiếp theo. Hai triệu lượt khám mỗi năm của Bạch Mai, kho tiêu bản giải phẫu bệnh của Chợ Rẫy và kho ảnh X-quang ngực của một bệnh viện tuyến tỉnh đều có thể đóng góp vào một mô hình dùng chung mà không phơi bày một bệnh án nào.
Điều này giải quyết quyền giữ dữ liệu. Nó không giải quyết tính bảo mật. Các bản cập nhật rời khỏi bệnh viện vẫn mã hóa thông tin về những hồ sơ chúng được huấn luyện trên đó; một bộ tổng hợp tò mò hoặc bị xâm nhập có thể suy luận liệu một bệnh nhân cụ thể có trong tập huấn luyện hay không. Vậy học liên kết đơn thuần không phải privacy machine learning y tế; nó chỉ là nền móng.
Lớp 2: Tổng hợp an toàn — không ai thấy bản cập nhật của bạn ngoài giá trị trung bình
Tổng hợp an toàn (secure aggregation) lấp khoảng trống bảo mật tại điểm trao đổi. Sử dụng tính toán đa bên (MPC), mỗi bệnh viện che bản cập nhật của mình bằng nhiễu ngẫu nhiên tự triệt tiêu khi các bản cập nhật của đủ bệnh viện được cộng lại. Bộ tổng hợp nhận được tổng — giá trị trung bình toàn cục mà nó cần — nhưng không thể tách riêng đóng góp của bất kỳ bệnh viện đơn lẻ nào. Các giao thức mới hơn (2026) chịu được một bộ tổng hợp ác ý và chạy trên mạng bất đồng bộ nơi bệnh viện có thể ngắt kết nối giữa chừng vòng huấn luyện.
Khi có tổng hợp an toàn, một bộ tổng hợp trung thực-nhưng-tò mò chỉ học được chuyển động trung bình của mô hình chứ không gì khác. Đây là lớp làm cho một liên minh nhiều bệnh viện trở nên khả thi về mặt pháp lý: không bệnh viện tham gia nào có thể bị xác định là nguồn của một tín hiệu huấn luyện cụ thể.
Lớp 3: Riêng tư vi phân — chính mô hình quên đi bệnh nhân của bạn
Tổng hợp an toàn bảo vệ điểm trao đổi; nó không ngăn được mô hình ghi nhớ. Riêng tư vi phân (differential privacy, DP) khắc phục điều đó bằng cách thêm nhiễu được hiệu chỉnh trong khi huấn luyện, sao cho hành vi của mô hình thay đổi không đáng kể dù hồ sơ của bất kỳ bệnh nhân đơn lẻ nào có được đưa vào hay không. Sự đảm bảo được định lượng bằng ngân sách riêng tư, ε (epsilon): ngân sách càng nhỏ, riêng tư càng mạnh và độ chính xác càng thấp.
DP có một đặc tính mà các nhà lãnh đạo IT bệnh viện cần nghe từ đầu: ngân sách là cạn kiệt được. Mỗi vòng huấn luyện trên dữ liệu của một bệnh nhân tiêu một phần ngân sách riêng tư của họ. Vì vậy việc chọn ε không phải là quyết định kỹ thuật — nó là quyết định lâm sàng và pháp lý về việc bệnh viện đánh đổi bao nhiêu độ chính xác để lấy bao nhiêu bảo vệ, được đưa ra một lần cho từng trường hợp sử dụng và được lập văn bản như bất kỳ quy trình lâm sàng nào. Trên các điểm chuẩn hình ảnh y tế, các mô hình huấn luyện bằng DP đã cho độ chính xác hàng đầu (kết quả NeurIPS 2024 trên phân loại tế bào máu) — cái giá là thật nhưng không quá cao.
Ba lớp kết hợp với nhau: hồ sơ nằm trong mỗi bệnh viện (FL), các bản cập nhật không thể liên kết với bất kỳ bệnh viện nào (tổng hợp an toàn), và mô hình cuối cùng không thể tiết lộ liệu có bệnh nhân cụ thể nào tham gia hay không (DP).
Zkml bệnh án: chứng minh việc huấn luyện chạy đúng trên dữ liệu nhạy cảm
Có một câu hỏi thứ tư mà cả ba lớp đều không trả lời: hãy chứng minh điều đó. Khi Bộ Y tế, một liên minh nghiên cứu hoặc một kiểm toán viên yêu cầu bệnh viện chứng minh rằng một mô hình chỉ được huấn luyện trên những hồ sơ đã đồng thuận — hoặc rằng mô hình đang chạy trong sản xuất đúng là mô hình đã được phê duyệt — thì hiện tại bệnh viện chẳng có gì để đưa ra ngoài một bản PDF có chữ ký. Zkml bệnh án lấp khoảng trống đó: máy học bằng chứng không tiết lộ (ZKML) tạo ra một bằng chứng mật mã chứng minh một phép tính đã chạy đúng, mà không tiết lộ bất cứ điều gì về dữ liệu mà nó sử dụng.
Trực giác giống hệt bằng chứng không tiết lộ (zero-knowledge proof) đang vận hành các blockchain riêng tư: một người chứng minh có một bí mật có thể thuyết phục người xác minh về một phát biểu mà không bao giờ tiết lộ bí mật. Áp dụng cho AI y tế, phát biểu có thể là "mô hình toàn cục này được huấn luyện bởi đúng ba bệnh viện có cam kết đã công bố, sử dụng đúng quy tắc tổng hợp đã thỏa thuận" — hoặc "suy luận này trên dữ liệu hình ảnh của bệnh nhân X được tạo ra bởi đúng phiên bản mô hình đã phê duyệt." Bằng chứng nhỏ gọn, việc xác minh mất mili giây, và bất kỳ ai — cơ quan quản lý, hội đồng nghiên cứu, công ty bảo hiểm — đều có thể kiểm tra nó mà không cần truy cập bệnh án.
Điều này không còn là lý thuyết. Kiến trúc zkFL-Health (2025) kết hợp học liên kết với bằng chứng không tiết lộ và một môi trường thực thi tin cậy: mỗi bệnh viện cam kết bản cập nhật cục bộ của mình, bộ tổng hợp tính bản cập nhật toàn cục bên trong một enclave được bảo vệ, và phát ra một bằng chứng ngắn gọn (Halo2/Nova) rằng nó đã dùng đúng các đầu vào đã cam kết và đúng quy tắc tổng hợp — trong khi không tiết lộ bản cập nhật của bệnh viện nào cho ai. Trong khi đó, ZKPROV (2025) chứng minh việc ràng buộc có thể xác minh giữa tập dữ liệu huấn luyện, tham số mô hình và đầu ra với thời gian tạo bằng chứng khoảng 3,3 giây cho mô hình tới 8 tỷ tham số, và Jolt Atlas (2026) đưa xác minh bằng chứng không tiết lộ vào các phép toán tensor ONNX. Các khối xây dựng cho một dự án thử nghiệm zkml bệnh án Việt Nam đã tồn tại ngay hôm nay.
Sự thận trọng trung thực, vay mượn từ những người phê bình chu kỳ thổi phồng ZKML: một bằng chứng không tiết lộ chứng minh rằng mạch đã chạy trung thực, chứ không phải rằng mô hình đúng về mặt lâm sàng. Một mô hình thiên vị hoặc một tập huấn luyện thiếu sót vẫn có thể được chứng minh là đã chạy đúng như được lập trình. ZKML mang lại cho bệnh viện trách nhiệm giải trình cho "điều gì đã được tính toán" — chứ không bao giờ là sự xá tội cho câu hỏi "tính toán cái đó có phải là điều đúng đắn không." Kiểm định lâm sàng vẫn là trách nhiệm của bệnh viện.
Pipeline huấn luyện riêng tư hoàn chỉnh
Lắp ráp cả bốn lớp cho ra một pipeline ánh xạ một-một với các nghĩa vụ pháp lý của Việt Nam.
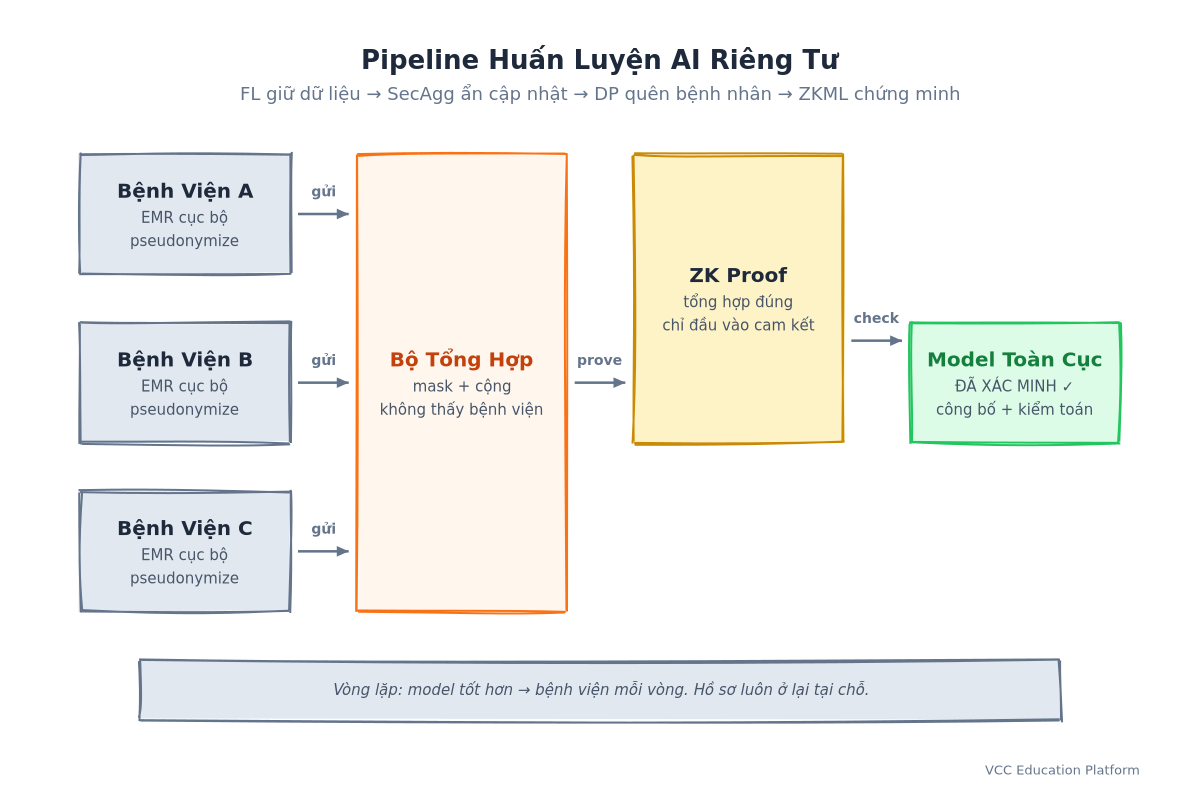
Pipeline có bảy giai đoạn. Mỗi bệnh viện chuẩn bị và giả danh hóa (pseudonymize) bản chụp EMR cục bộ phía sau tường lửa của chính mình (đây là nơi tốn phần lớn chi phí kỹ thuật thật — chuẩn hóa lược đồ, đối chiếu mã ICD-10, trích xuất đặc trưng). Một bộ điều phối phát đi mô hình toàn cục hiện tại. Mỗi bệnh viện huấn luyện cục bộ trong vài epoch, áp dụng ngân sách riêng tư riêng của từng bệnh viện, và che bản cập nhật của mình cho tổng hợp an toàn. Bộ tổng hợp gộp các bản cập nhật đã che, xác minh chúng so với các cam kết đã công bố, và tạo ra một mô hình toàn cục mới kèm một bằng chứng không tiết lộ rằng việc tổng hợp đã chạy đúng trên đúng các đầu vào đã cam kết. Mô hình và bằng chứng được công bố; dữ liệu bệnh nhân không bao giờ di chuyển.
Với trường hợp sử dụng tại giường bệnh theo thời gian thực, cùng kiến trúc đó áp dụng ở chế độ suy luận: bệnh viện chạy mô hình đã phê duyệt trên dữ liệu hình ảnh của bệnh nhân mới tại chỗ, tạo một bằng chứng rằng đúng phiên bản mô hình đã phê duyệt sinh ra đầu ra đó, và trình nó lên mà không phơi bày trọng số hoặc hồ sơ. Thời gian tạo bằng chứng cho các mô hình sàng lọc quy mô bệnh viện là vài giây đến vài phút trên GPU; xác minh mất mili giây. Điều đó làm cho pipeline phù hợp với kiểm toán quy định và báo cáo định kỳ ngay hôm nay, nhưng chưa phù hợp cho hỗ trợ quyết định thời gian thực nơi độ trễ dưới giây là bắt buộc — đây là đánh đổi đầu tiên bên dưới.
Ba đánh đổi trung thực cho AI y tế
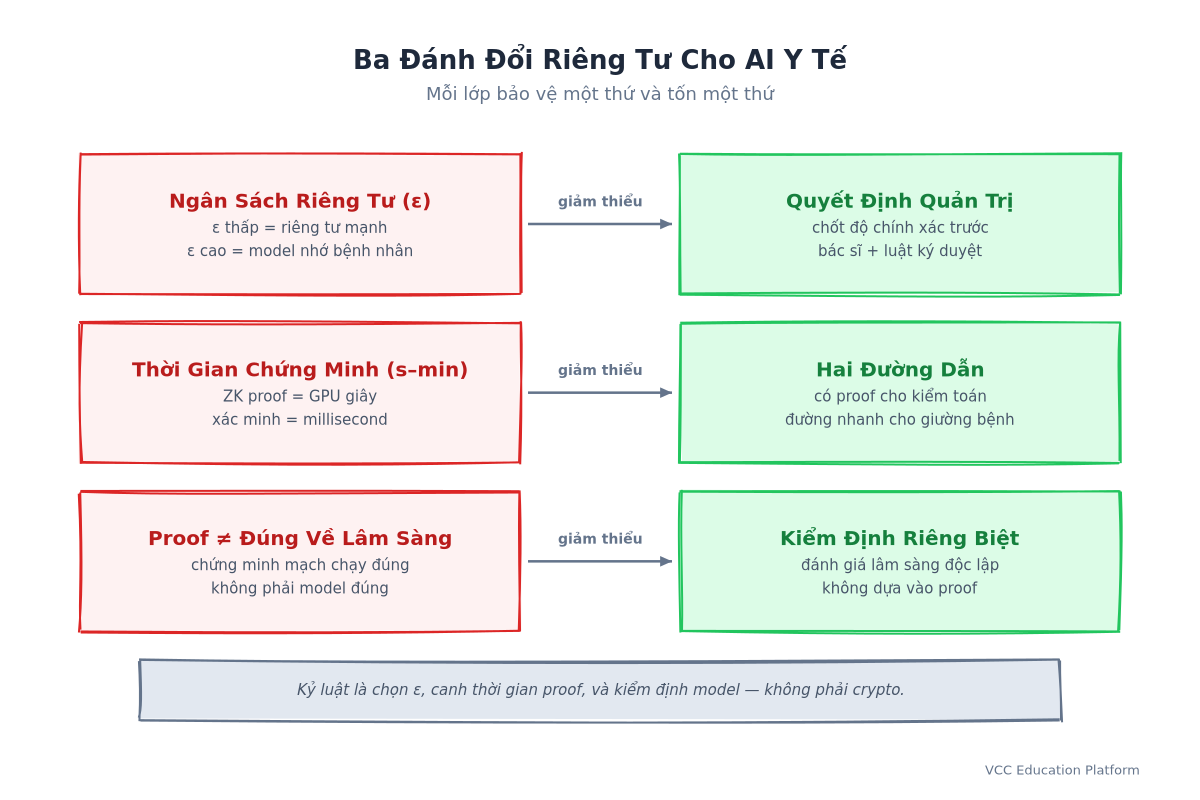 Đánh đổi 1: Ngân sách riêng tư so với độ chính xác lâm sàng. Riêng tư vi phân là một đồng tiền thật và cạn kiệt được. Mỗi vòng huấn luyện tiêu một phần ε của mỗi bệnh nhân; đẩy ε xuống quá thấp thì dự đoán suy giảm, đẩy ε lên quá cao thì mô hình bắt đầu ghi nhớ từng bệnh nhân. Giải pháp là quản trị theo từng trường hợp sử dụng: ấn định trước một mức sàn độ chính xác chấp nhận được, tính ε đạt được nó, và để một bác sĩ lâm sàng cùng một cán bộ pháp chế ký duyệt — y như cách một phác đồ điều trị được phê duyệt.
Đánh đổi 2: Chi phí chứng minh so với tính kịp thời. Tạo bằng chứng không tiết lộ là bước đắt nhất (vài giây đến vài phút trên GPU cho mô hình trung bình); xác minh rẻ và tức thì. Sự bất đối xứng này hợp với các tác vụ kiểm toán định kỳ, bất đồng bộ vốn chiếm phần lớn công việc tuân thủ của bệnh viện — một vòng liên minh hàng tháng, một báo cáo quy định hằng năm — nhưng không hợp với suy luận tại giường bệnh theo thời gian thực. Câu trả lời thực dụng là tách hai đường: suy luận nhanh không có bằng chứng cho chăm sóc tại giường, suy luận có bằng chứng cho mọi thứ sẽ bị kiểm toán hoặc công bố.
Đánh đổi 3: Cái bẫy "rác vào, chân lý ra". Một bằng chứng tính toán đúng có thể gán quyền uy giả cho một mô hình thiếu sót. Pipeline bảo vệ đường ống dữ liệu — hồ sơ đến từ đâu, chúng được tổng hợp thế nào, phiên bản mô hình nào đã chạy — chứ không bảo vệ giá trị lâm sàng của mô hình. Hãy giữ việc kiểm định mô hình (độ chính xác, độ chệch giữa các vùng miền, hiệu chỉnh) là một quy trình riêng, thông thường. Một bằng chứng là biên lai cho một phép tính; nó không phải là một ý kiến y khoa.
Lộ trình thực tế cho bệnh viện và startup công nghệ y tế Việt Nam
Con đường thực tế, cho một bệnh viện hoặc một startup công nghệ y tế phục vụ bệnh viện:
Bước 1: Chọn một trường hợp sử dụng ít rủi ro, khối lượng cao. Bắt đầu với phân loại và chấm điểm rủi ro — đánh dấu X-quang ngực, dự đoán nguy cơ nhập viện, dự đoán tái nhập viện — chứ không phải chẩn đoán trực tiếp. Những việc này mang lại giá trị đo được với một bề mặt đạo đức nhỏ. Bước 2: Chuẩn hóa và giả danh hóa dữ liệu trước tiên. Đây là 80% công việc thật. Chuẩn hóa lược đồ EMR, đối chiếu mã ICD-10, tách bỏ các định danh, và quản lý phiên bản cho đường ống trích xuất. Nếu đường ống dữ liệu không đáng tin cậy, mọi lớp riêng tư bên trên nó chỉ là màn kịch. Bước 3: Xây nền FL + tổng hợp an toàn. Dùng một framework mã nguồn mở (Flower, TensorFlow Federated, PySyft) trong một hộp cát với hai hoặc ba lát bệnh viện tổng hợp. Đo độ chính xác so với mốc tập trung trước khi thêm các cơ chế riêng tư. Bước 4: Thêm riêng tư vi phân và đo chi phí ở mức ε mục tiêu. Ghi độ chính xác tại ε = 1, 5, 10 và để đội lâm sàng chọn điểm phù hợp. Lập văn bản quyết định như một đánh giá tác động bảo vệ dữ liệu (DPIA) theo Nghị định 13/2023 — dù sao pháp luật cũng bắt buộc, và nó ép buộc cuộc hội thoại quản trị diễn ra sớm. Bước 5: Chỉ thêm ZKML khi một bên ngoài phải xác minh. Với một mô hình đơn nội bộ trong bệnh viện, bằng chứng không tiết lộ hôm nay là sự thiết kế thừa. Hãy thêm chúng khi cơ quan quản lý, liên minh nghiên cứu hoặc khách hàng trả phí cần bằng chứng có thể kiểm tra độc lập — khi đó bằng chứng zkml bệnh án trở thành tài sản bán hàng thay vì một khoản chi phí.Các câu hỏi thường gặp
Privacy machine learning y tế có hiệu quả nếu bệnh viện của tôi không có GPU và không có đội ML?
Có — đây là điểm vào phổ biến nhất. Một bệnh viện không cần tự chạy huấn luyện chút nào: nó có thể tham gia một liên minh với vai trò người đóng góp dữ liệu trong khi một đối tác công nghệ y tế điều phối, miễn là tổng hợp an toàn đảm bảo đối tác không thể thấy bản cập nhật của bệnh viện. Nghĩa vụ của bệnh viện là chất lượng dữ liệu và giả danh hóa; khối lượng tính toán có thể ở nơi khác.
Huấn luyện ai riêng tư và zkml bệnh án khớp với nhau thế nào trong thực tế?
Huấn luyện ai riêng tư là phương pháp huấn luyện: học liên kết giữ hồ sơ ở nguyên vị trí, tổng hợp an toàn giấu bản cập nhật của từng bệnh viện, và riêng tư vi phân ngăn mô hình ghi nhớ bệnh nhân. Zkml bệnh án là lớp bằng chứng bên trên: nó cho phép liên minh chứng minh với kiểm toán viên rằng việc huấn luyện đã dùng đúng dữ liệu đã cam kết, đã đồng thuận và đúng quy tắc tổng hợp đã thỏa thuận. Huấn luyện sinh ra mô hình; bằng chứng không tiết lộ sinh ra biên lai làm cho việc huấn luyện đó có thể bảo vệ được.Riêng tư vi phân có làm giảm độ chính xác đủ để ảnh hưởng lâm sàng không?
Trên các tác vụ dự đoán có cấu trúc (điểm rủi ro, cờ phân loại) chi phí độ chính xác ở mức ε hợp lý thường nhỏ nhưng không bằng không, và nó phải được đo cho từng trường hợp sử dụng chứ không được giả định. Hãy ấn định sàn độ chính xác lâm sàng trước, rồi tìm ε thỏa mãn nó — và nhớ rằng một mô hình không được bảo vệ riêng tư làm lộ hồ sơ bệnh nhân đã thất bại bất kể AUC của nó là bao nhiêu.
Bệnh viện nên làm gì nếu một nhà cung cấp xin bản sao hồ sơ để huấn luyện "mô hình của họ"?
Hãy coi đó là một sự kiện pháp lý, không phải sự kiện kỹ thuật. Theo Nghị định 13/2023, dữ liệu sức khỏe trong bệnh án là dữ liệu cá nhân nhạy cảm; chuyển nó đòi hỏi sự đồng ý, một thỏa thuận xử lý được lập văn bản, và bệnh viện vẫn chịu trách nhiệm sau khi chuyển. Câu trả lời ML riêng tư — huấn luyện liên kết, tổng hợp an toàn, chứng minh bằng không tiết lộ — mang lại cùng một mô hình mà không cần chuyển dữ liệu. Nếu nhà cung cấp không thể làm việc dưới ràng buộc đó, họ không xây dựng privacy machine learning y tế; họ đang xây dựng một doanh nghiệp thu thập dữ liệu.
Kết luận
Các bệnh viện Việt Nam đang ngồi trên một trong những kho dữ liệu giá trị nhất và bị quản lý chặt chẽ nhất của đất nước. Chiến dịch đẩy mạnh EMR của Bộ Y tế đã số hóa hơn 1.200 bệnh viện; Bạch Mai và Chợ Rẫy đang huấn luyện AI trên chính hồ sơ của họ ngay hôm nay. Câu hỏi chưa bao giờ là dữ liệu có đủ tốt hay không — nó là — mà là bệnh viện huấn luyện AI trên hồ sơ bệnh nhân nhạy cảm như thế nào mà không vi phạm Nghị định 13/2023, Luật Khám bệnh, chữa bệnh, hay lòng tin của từng bệnh nhân. Câu trả lời là một pipeline phân lớp: học liên kết cho quyền giữ dữ liệu, tổng hợp an toàn cho tính bảo mật, riêng tư vi phân cho bảo vệ cấp bệnh nhân, và bằng chứng không tiết lộ cho trách nhiệm giải trình. Mỗi lớp có một cái giá thật, và kỹ thuật trung thực — chọn ε, canh thời gian bằng chứng, kiểm định mô hình — là nơi kỷ luật cư trú. Các bệnh viện xây dựng điều này bây giờ sẽ là những người định nghĩa AI y tế có trách nhiệm trông như thế nào tại Việt Nam.
---
Tham Khảo Nhanh
| Lớp | Bảo vệ điều gì | Không bảo vệ điều gì | Chi phí điển hình |
| --- | --- | --- | --- |
| Học liên kết | Quyền giữ dữ liệu (hồ sơ không rời bệnh viện) | Tính bảo mật của bộ nhớ mô hình | Số vòng truyền thông, GPU cục bộ |
| Tổng hợp an toàn | Tính bảo mật của bản cập nhật (không ai thấy bản cập nhật của bệnh viện) | Mô hình ghi nhớ từng bệnh nhân | Chi phí giao thức MPC |
| Riêng tư vi phân | Bảo vệ cấp bệnh nhân (hành vi mô hình ≈ có/không một bệnh nhân) | Khả năng kiểm toán, xuất xứ | Giảm độ chính xác tại ε đã chọn |
| ZKML (zkml bệnh án) | Trách nhiệm giải trình (chứng minh huấn luyện/suy luận chạy trên dữ liệu đã cam kết) | Tính đúng đắn lâm sàng của mô hình | Thời gian tạo proof GPU (s–phút), xác minh ms |
| Nền tảng pháp lý (VN) | Dữ liệu nhạy cảm theo Nghị định 13/2023/NĐ-CP; Luật 15/2023/QH15 Điều 10/69 | — | Đánh giá tác động, khung đồng thuận |
| Mô hình tham chiếu | GDPR Điều 9 (sức khỏe = danh mục đặc biệt) | — | — |
| Trường hợp sử dụng đầu tiên tốt nhất | Phân loại, rủi ro nhập viện, dự đoán tái nhập viện | — | — |
| Bộ công cụ mã nguồn mở | Flower, TensorFlow Federated, PySyft, OpenMined, EZKL | — | — |